
RAG 调优和模型微调分别在改什么
目录
本文通过虚构教学案例比较调整方法,不包含实际训练、部署或效果测量记录。
先说清楚,要调整的是哪一层
知识库回答不符合预期时,一句“把效果微调一下”可能包含完全不同的工作:修改切片长度、增加候选数量、调整提示,或者准备数据训练模型。
这些动作会改变不同的东西,也需要不同的验证方式。如果资料根本没有进入模型输入,先训练生成模型未必能解决缺失;如果证据完整且任务行为仍持续不稳定,才值得进一步评估训练是否合适。
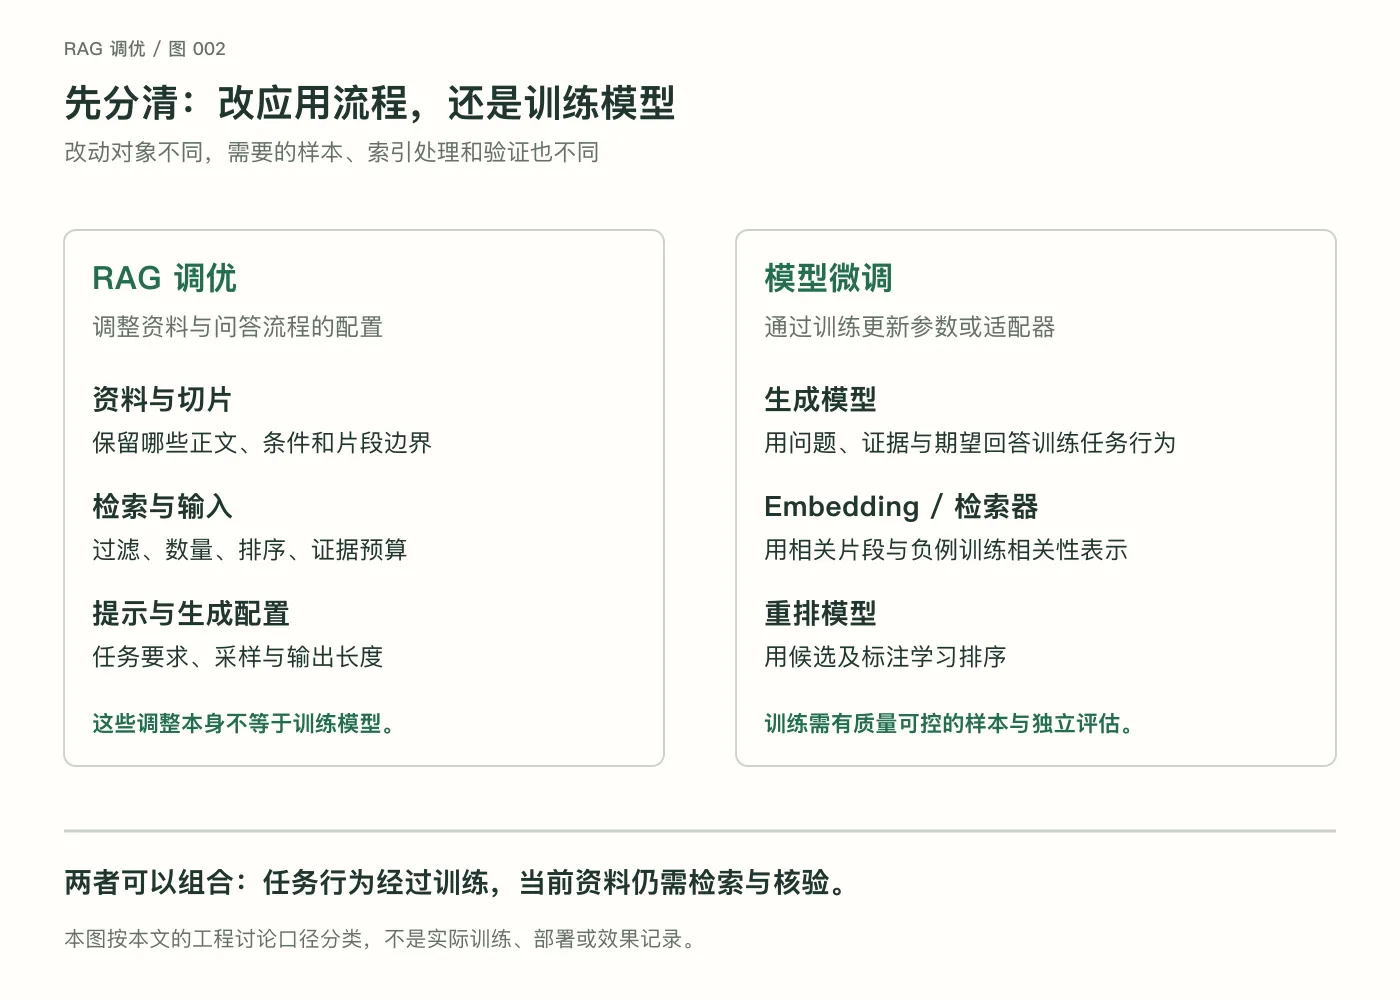
为了明确讨论对象,本文把切片、检索、输入组装和生成配置的改进称为“RAG 调优”,把更新模型权重或可训练适配器的过程称为“模型微调”。这是本文采用的工程讨论口径。
用一条问答链路区分改动对象
以一个虚构账号问题为例:用户问培训环境的账号找谁申请,审批后多久开通。资料 A 规定申请与审批流程,资料 B 规定审批通过后由管理员在 1 个工作日内开通。
一次回答至少涉及以下环节:
flowchart TD
A[整理和切分资料] --> B[编码、建立索引并检索候选]
B --> C[筛选证据,组装问题与上下文]
C --> D[生成答案,核对事实与引用]
调整切片,改变的是每条可检索内容的边界;调整 TopK,改变的是某一步最多保留多少候选;调整提示,改变的是本次请求对回答任务的要求。它们都可以在不训练模型的情况下改变最终结果。
模型微调则需要训练样本和优化过程,改变模型参数或适配器。它也可以发生在不同部件上:生成模型、Embedding 或检索器、重排模型,训练目标各不相同。
RAG 调优:先让需要的证据到达模型
如果回答漏了时限,应先检查 B 在哪里消失。B 被切掉了必要条件,需要检查切片;B 排在第二名却只保留一条,需要检查数量限制;B 已取回但没进入请求,需要检查输入预算。
这些问题可以分别对应到具体调整:
| 调整对象 | 改变什么 | 怎样验证 |
|---|---|---|
| 资料与解析 | 系统实际读取到哪些事实、标题和条件 | 对照原文检查解析结果,确认有效版本 |
| 切片与相邻内容 | 每个检索单元包含哪些上下文 | 检查条件与结论是否完整,是否带入过多无关内容 |
| 检索方式 | 如何找到候选 | 在固定问题集上检查预期证据有没有被找回 |
| 候选数量、过滤与排序 | 哪些候选留下,顺序如何 | 检查排除原因、范围条件和最终证据覆盖 |
| 输入组装 | 哪些内容真正进入请求 | 检查实际输入,确认 B 及其审批前提完整保留 |
| 提示与输出约束 | 如何组织回答、处理缺失和提供引用 | 对照证据检查答案,复测资料不足的情况 |
选择检索方式也要对应问题。精确编号、文号和专业术语值得单独测试;语义相近的问题则可能受益于向量表示。Microsoft 的混合检索说明介绍了关键词与向量检索的互补,但其服务中的融合实现不能直接当成所有系统的行为,更不能据此保证自己的数据上一定更好。
调整是否有效,要看证据与答案的对照。只把最终答案读起来是否流畅作为标准,很容易漏掉资料没有覆盖、适用环境错误或引用不支持结论的问题。
temperature 调整生成选择,不补充缺失资料
如果 B 没有进入请求,调低 temperature 不会把 B 自动取回来。模型需要的时限仍然缺少依据。
在支持相应采样策略的服务中,temperature 影响生成时的概率分布,top_p 限制采样候选集合;输出长度上限约束允许生成的长度。具体含义和是否生效需要按接口与解码策略核对。例如,Transformers 的 Generation 文档分别定义了采样开关、temperature、top_p 和 max_new_tokens。
这几类设置可以影响表达与长度,却不能保证事实正确。输入中已经有 B,仍然写错时限,需要检查任务要求、证据使用与输出核验;输入中没有 B,则应先回到资料与检索链路。
这里还容易混淆两个名字:检索中的 TopK 表示候选资料的数量限制,生成采样中的 top_k 表示候选 Token 的限制。虽然名称相近,改动对象并不相同,配置和诊断记录应写清所在环节。
模型微调:用样本改变任务行为或相关性表示
当输入、检索与验证流程已经基本清楚,某种任务行为仍持续不稳定时,可以评估模型微调。不过,在准备训练前,需要先说清楚要训练哪个部件、样本是什么,以及要改善哪个可测量的问题。
| 微调对象 | 样本可以包含什么 | 希望改善的能力 | 仍要保留的检查 |
|---|---|---|---|
| 生成模型 | 问题、证据、符合要求的回答,以及资料不足示例 | 依据证据回答、引用、固定格式和领域表达 | 当前资料是否提供,答案是否得到证据支持 |
| Embedding 或检索器 | 问题、相关片段、措辞相近但不适用的负例 | 业务表达的相关性表示与候选召回 | 新旧编码兼容性、固定问题集上的检索效果 |
| 重排模型 | 同一问题下的候选片段与相关性标注 | 候选的优先级 | 正确片段是否已被初次检索取回 |
在账号案例中,生产规则可能与培训问题很相似,却不适用。这可以用于解释负例的意义,但本文并没有据此制作训练集或完成训练。重排也只能处理已经送到它面前的候选,初次检索完全漏掉 B 时,后续排序没有 B 可选。
LoRA 是模型微调的一种方法。PEFT 的 LoRA 说明介绍了冻结原始权重、训练较小低秩更新矩阵的方式。选用了这种方法,仍然需要决定训练数据、目标模块和适配器规模,并通过验证判断收益;不能只凭可训练参数减少,就宣称某项任务已经变好。
哪些变化需要重新处理索引
改完配置后,另一个实际问题是:已有文档向量还能不能继续使用?
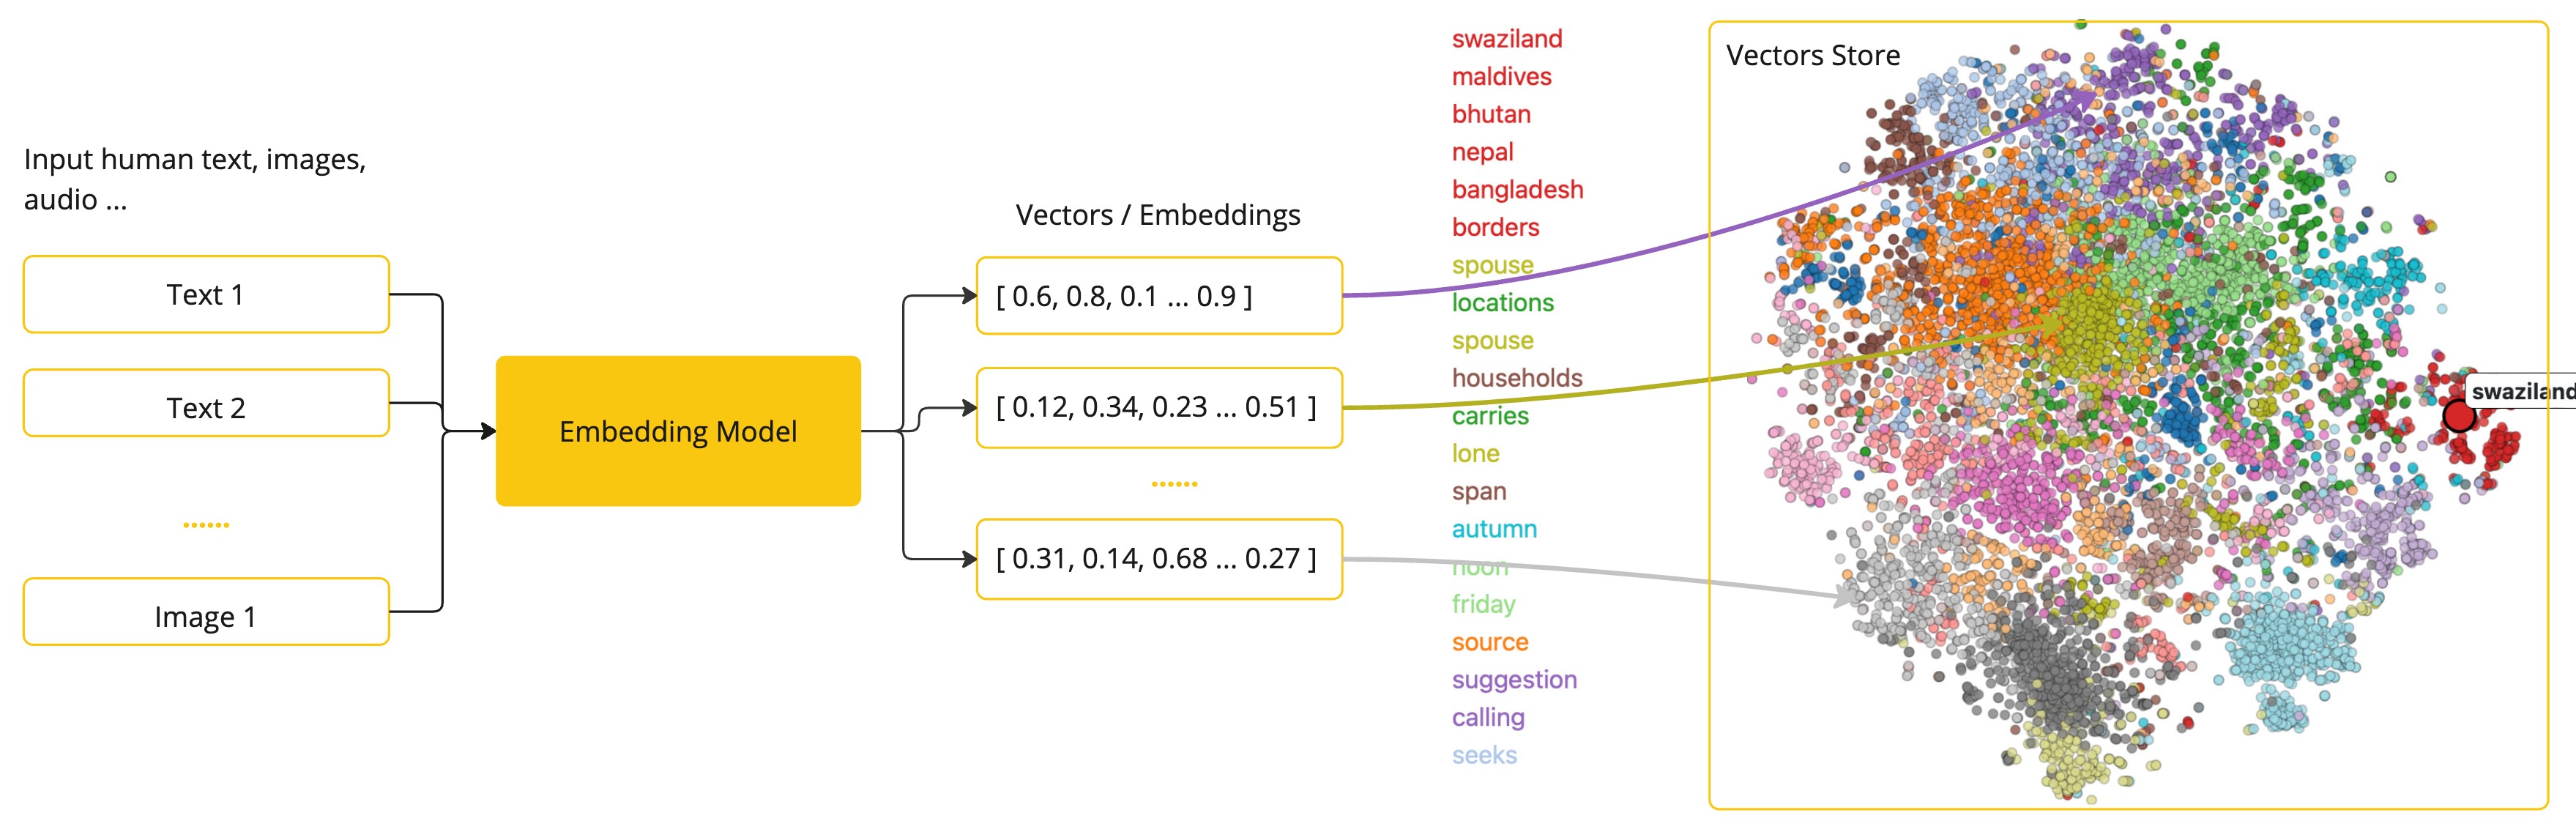
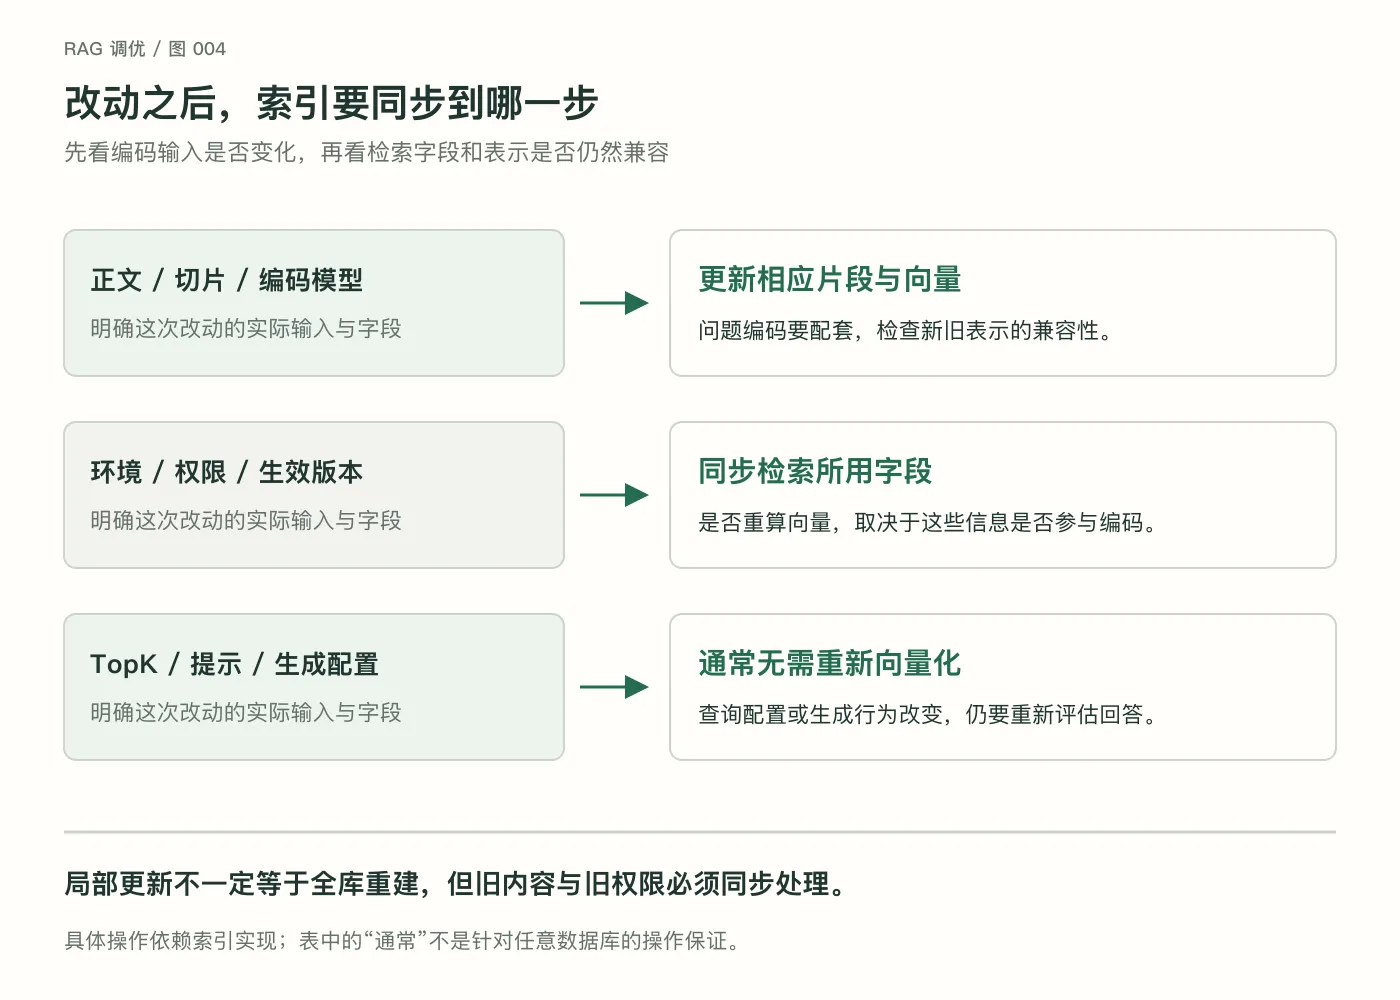
判断时,可以追问两件事:用于编码的内容是否改变,检索依赖的字段或结构是否改变。前者关系到向量是否仍代表当前内容,后者关系到查询和过滤是否仍然正确。
| 修改 | 对索引的通常影响 | 需要注意的条件 |
|---|---|---|
| 正文、切片边界、参与编码的标题或前缀 | 更新受影响的片段与向量 | 不必把局部更新一概理解为全库重建,但旧内容必须同步退出或更新 |
| Embedding 模型、维度或经过训练的编码表示 | 通常需要重算相应文档向量,并检查索引兼容性 | 问题编码也必须配套,不能只确认维度相同 |
| 环境、权限和生效版本等元数据 | 必须同步检索使用的字段 | 是否重算向量取决于这些信息是否参与编码;权限更新不能只停留在管理页面 |
| TopK、门槛与重排配置 | 通常不需要重新向量化资料 | 特定服务的索引或查询结构变化需另外核对 |
| 提示、生成参数、生成模型 | 通常不需要重建文档向量 | 仍需重新评估事实、引用与缺失处理 |
这张表是基于本文所述流程的工程判断,不是某个数据库的操作手册。具体更新方式还要看索引实现和编码输入,不能仅凭“只是改了元数据”就跳过同步检查。
RAG 与训练可以组合,资料更新仍要单独管理
在常见的资料入库流程中,给现有片段重新编码和建立索引,不等于训练生成模型。但把这一点推广成“RAG 永远不涉及训练”也不准确:原始 RAG 论文本身就研究了检索增强生成模型的微调方法。
在工程讨论里,应把入库、推理调用与训练过程分别说明。一个模型可以经过任务微调,再读取检索到的最新资料;一次资料更新,也可以只改变检索内容而不重新训练生成模型。
如果培训规则从 1 个工作日改成 2 个工作日,当前有效证据必须同步更新。即使模型学会了稳定的回答格式,也仍需要拿到新规则。训练解决的任务行为问题,不能代替资料版本管理。
验证方式要跟着改动对象走
本文建议先固定问题、预期证据和当前配置,再围绕一个已确认原因做调整。检索调整看所需片段能否取回;输入调整看必要事实能否完整进入;生成调整看答案与引用是否忠实;训练则还需要独立的验证与测试数据。
参与训练的题目可以用于检查学习过程,却不能直接证明模型能处理未见过的问题。训练数据质量、学习率、轮数、批量大小和样本截断,都应结合验证结果判断,而不是从一次顺畅回答里推断成功。
比较结果时,也要复测原本正确、资料不足和范围干扰的问题,并分别记录运行延迟与成本。本文不提供通用最优参数,因为这些取舍需要实际任务证据。
RAG 调优与模型微调都可能改变最终答案。先明确失败位置、改动对象和验证指标,才能判断下一步需要修改资料、调整应用,还是准备一次有依据的训练实验。
参考资料
- Microsoft:Hybrid search using vectors and full-text search,用于核对关键词与向量检索的互补,本文不复用该服务的效果声明。
- Hugging Face Transformers:Generation,用于核对采样、生成长度及相关参数的定义。
- Hugging Face PEFT:LoRA,用于核对低秩适配器的基本训练方式。
- Lewis 等:Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks,2020,用于核对原始方法包含模型微调。
- Spring AI:AI Concepts,图 003 的原始上下文,为本文附图来源。