
从人工查资料理解 RAG:知识库问答到底多做了什么
目录
本文使用虚构制度说明原理,不包含真实公司规定或系统运行结果。
模型能理解问题,为什么仍然答不出来
“培训环境的账号应该找谁申请,审批后多久能开通?”
一个通用语言模型可能理解申请、审批和开通的含义,却不知道这家公司采用哪一份制度。要回答这个问题,需要的不是更流畅的措辞,而是包含申请流程和开通时限的资料。
人也一样。新同事来问,我们会打开制度,找到相关段落,确认适用环境,再把分散的信息整理成回答。RAG,也就是检索增强生成,把这段查找与提供资料的过程接入了模型问答:应用先检索内容,再把问题和选出的证据交给模型生成回答。Microsoft 的 RAG 概念说明描述了这一基本过程。
理解这条链路,可以先从人怎样查资料开始。
先用两份资料回答一个问题
假设有三份制度,以下内容全部为虚构示例:
| 资料 | 内容 | 适用范围 |
|---|---|---|
| A:账号申请流程 | 向培训负责人提交申请,由培训负责人审批 | 培训环境 |
| B:账号开通说明 | 审批通过后,由管理员在 1 个工作日内开通 | 培训环境 |
| C:权限申请说明 | 向信息安全负责人申请,审批后 3 个工作日内开通 | 生产环境 |
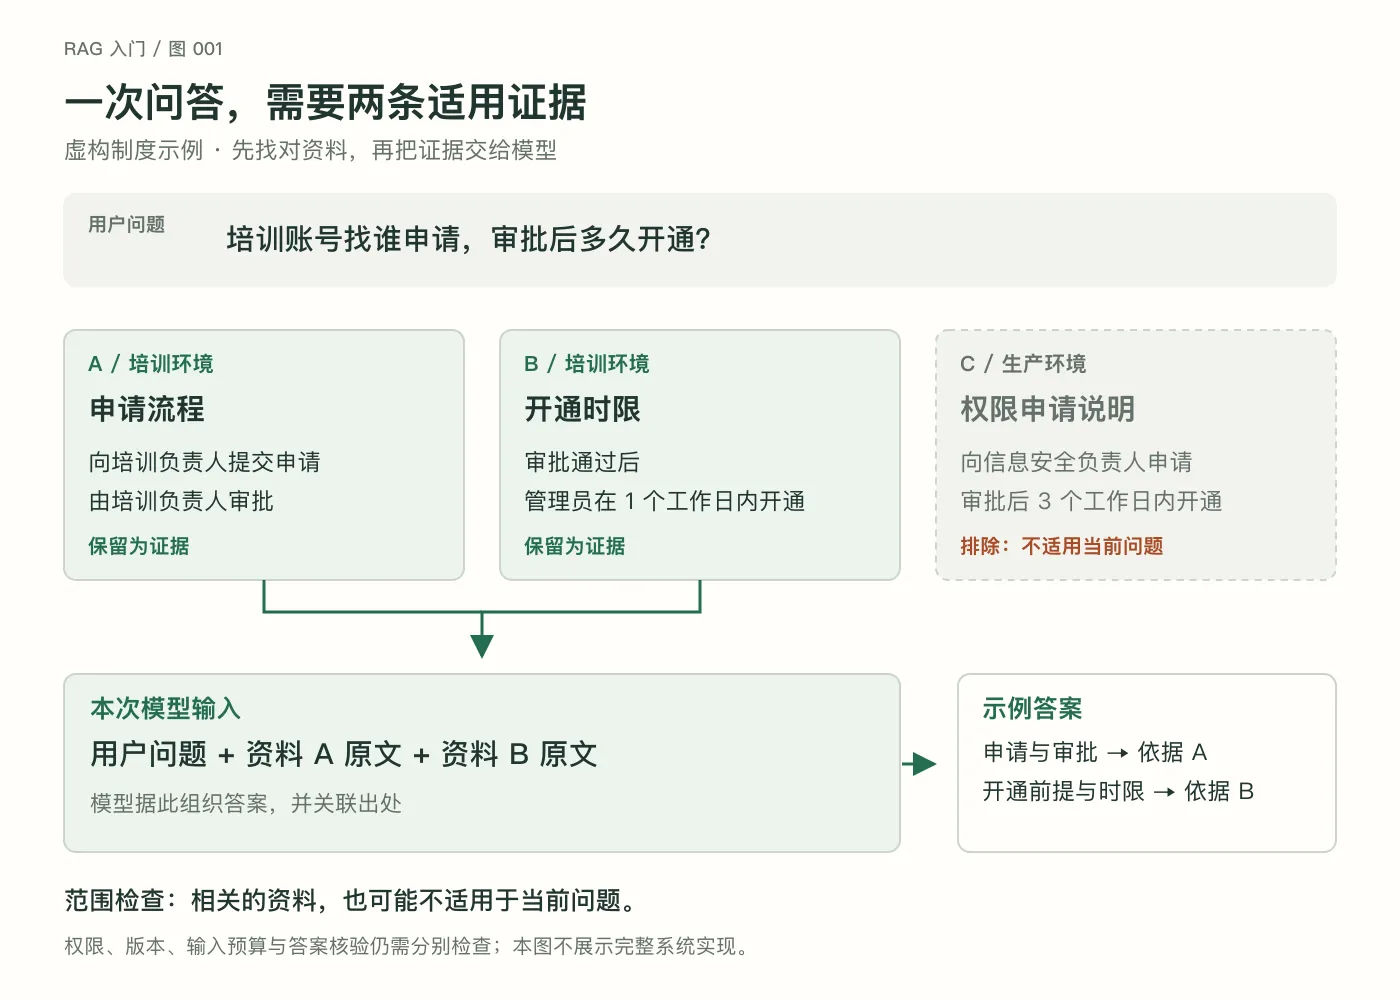
问题里有两件事:找谁申请,以及审批后多久开通。A 回答前一件,B 回答后一件,C 虽然也在讲账号申请,却属于不同环境,不能拿来回答。
基于 A、B,可以组织出这样的示例答案:
向培训负责人提交申请,由培训负责人审批。依据:资料 A。审批通过后,由管理员在 1 个工作日内开通。依据:资料 B。
这句话的依据很具体。如果没有读到 B,就不能补上时限;如果误用了 C,回答可能写得很完整,却把生产制度套到了培训问题上。
人完成了查找、筛选、合并和标注出处。程序要做的工作也可以沿着这些步骤理解。
提问之前,先让资料变得可查
资料最初可能是长文档、表格或说明页面。应用要先解析出内容和结构,再把它们组织成适合查找的单元,并保留来源位置、版本和适用条件。
这就是切片要解决的问题。一份手册可能同时包含账号申请、浏览器设置和设备借用。用户只问账号,系统需要定位其中有关的段落,而不是每次把整本手册都交给模型。
但切得越碎,也不一定越好。看这句示例规则:
培训账号审批通过后,由管理员在 1 个工作日内开通。
“审批通过后”是时限的前提。如果一片只留下前提,另一片只留下“1 个工作日内开通”,取回后一片时就可能把计时起点弄丢。读者会误以为提交申请后就开始计时。
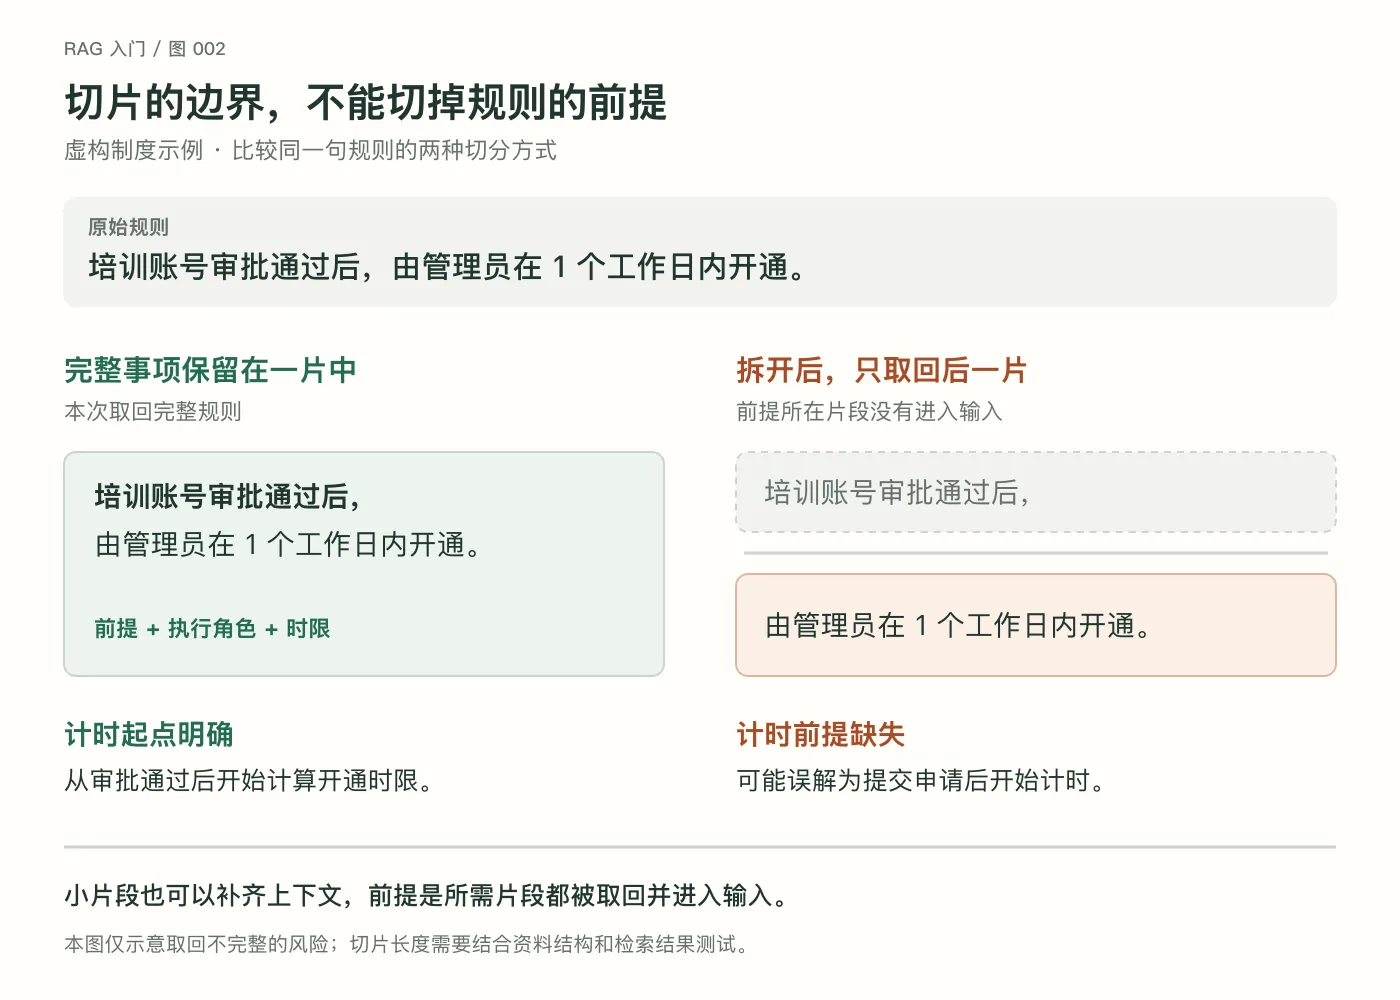
因此,切片需要同时考虑长度和完整性。按标题、段落或完整事项切分,可以利用文档结构;是否需要重叠、相邻段落补充,则要结合资料和检索结果判断。Microsoft 的切片说明也列出了固定长度与按内容结构切分等方法。
片段还应关联适用环境等信息。A、B 属于培训环境,C 属于生产环境,这个差别不能靠相似度分数代替。元数据必须有原文或明确管理规则作为依据,不能让模型猜一个标签就当真。
向量帮助找资料,原文仍然要取回来
用户可能问“多久能登录”,资料里写的是“账号开通时限”。两种说法没有完全相同的字面形式,却可能指向同一件事。
在向量检索方案中,Embedding 模型把问题和资料编码成数字表示,应用通过比较这些表示查找候选片段。问题与资料的编码需要兼容;例如,DPR 研究采用了双编码器框架,不能把所有方案都简化成必须共用完全相同的编码器。
余弦相似度是比较向量的一种方法,可以借助箭头方向形成直觉:方向越接近,余弦值越大。下图来自 Spring AI 文档,用二维向量说明方向关系。
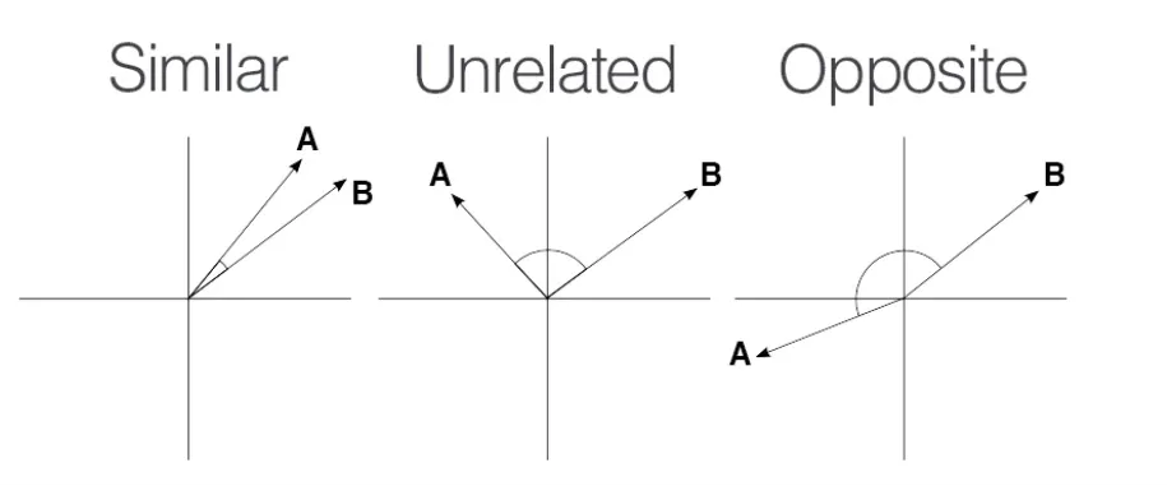
图中的 A、B 是向量符号,与前文制度 A、B 没有对应关系。几何方向也不能直接解释为文本事实互相矛盾;真实文本向量通常不止二维,图中不是实际模型的编码结果。
检索找到候选后,应用还要通过片段关联取回原文。最后交给生成模型阅读的是问题和文字证据。向量在这里承担查找工作,并没有替代制度正文。
这也解释了为什么分数高仍然可能选错:C 和问题都包含账号、申请、审批、开通等内容,可能具有较高相关性,但适用范围不对。相关程度与能否用于回答,是两项检查。
向量检索只是可选实现之一。RAG 也可以使用关键词检索,或组合多种检索方式。是否采用向量数据库,不是识别这条问答流程的唯一标准。
找到资料之后,还要决定模型实际读到什么
候选列表并不会自动成为模型输入。应用还需要检查权限和范围、筛选候选,再按照输入预算组装证据。
flowchart TD
D[解析资料并保留来源] --> C[组织可检索片段]
C --> I[建立检索索引]
Q[用户问题] --> R[检索候选]
I --> R
R --> F[检查权限 范围与证据覆盖]
F --> P[把问题和证据组成输入]
P --> G[生成回答并标注出处]
G --> V[对照原文核验]
假如只允许取一条候选,A 被选中而 B 没有被选中,系统就只有申请流程,没有时限。如果 B 已经被检索出来,却因输入预算不足而没有放进去,模型依然缺少这部分依据。
所以,“找到了 B”和“模型读到了 B”需要分别确认。输入容量、候选数量和片段长度都会影响证据是否完整,不能只看检索列表里有没有某个关键词。
有引用的回答,也要回到原文检查
应用可以要求模型根据资料作答、标注出处,并在资料不足时说明缺失。但要求写进提示,并不意味着结果会自动正确。
核验示例答案时,至少要问:申请对象是否由 A 支持,开通时限是否由 B 支持,“审批通过后”这个条件有没有保留,引用的是否为正确环境和版本。
如果用户进一步问“账号什么时候自动过期”,A、B 都没有规定期限。此时说明资料未覆盖这个事实,比从其他账号制度里拼出一个期限更有依据。
引用提供了检查入口,不能替代检查本身。RAG 增加了本次回答可使用的资料,也增加了从答案回到证据的路径;资料选错、输入遗漏或生成偏离,仍然会造成错误。
理解这条链路,再看技术名词
从人工查资料出发,解析和切片是在整理可查内容,检索是在找候选,过滤是在确认范围与权限,输入组装是在决定本次交给模型读什么,生成是在组织回答,引用核验是在检查每项事实的依据。
这套流程没有要求我们先记住一长串组件名称。先看清回答需要哪些事实,以及这些事实怎样进入模型输入,再去选择具体的检索方法和工具,才容易判断每个部件究竟解决了什么问题。
参考资料
- Microsoft:Retrieval augmented generation (RAG) and indexes,用于核对检索、输入增强与生成的基本过程。
- Microsoft:Chunk large documents for RAG and vector search,用于核对切片与输入限制、结构化分段的关系。
- Karpukhin 等:Dense Passage Retrieval for Open-Domain Question Answering,2020,用于核对稠密检索和双编码器方法,不引用其测评数字推断本文案例的效果。
- Spring AI:Understanding Vectors,用于核对向量方向与余弦相似度的解释,并提供图 003。